Видео с ютуба Moe Inference
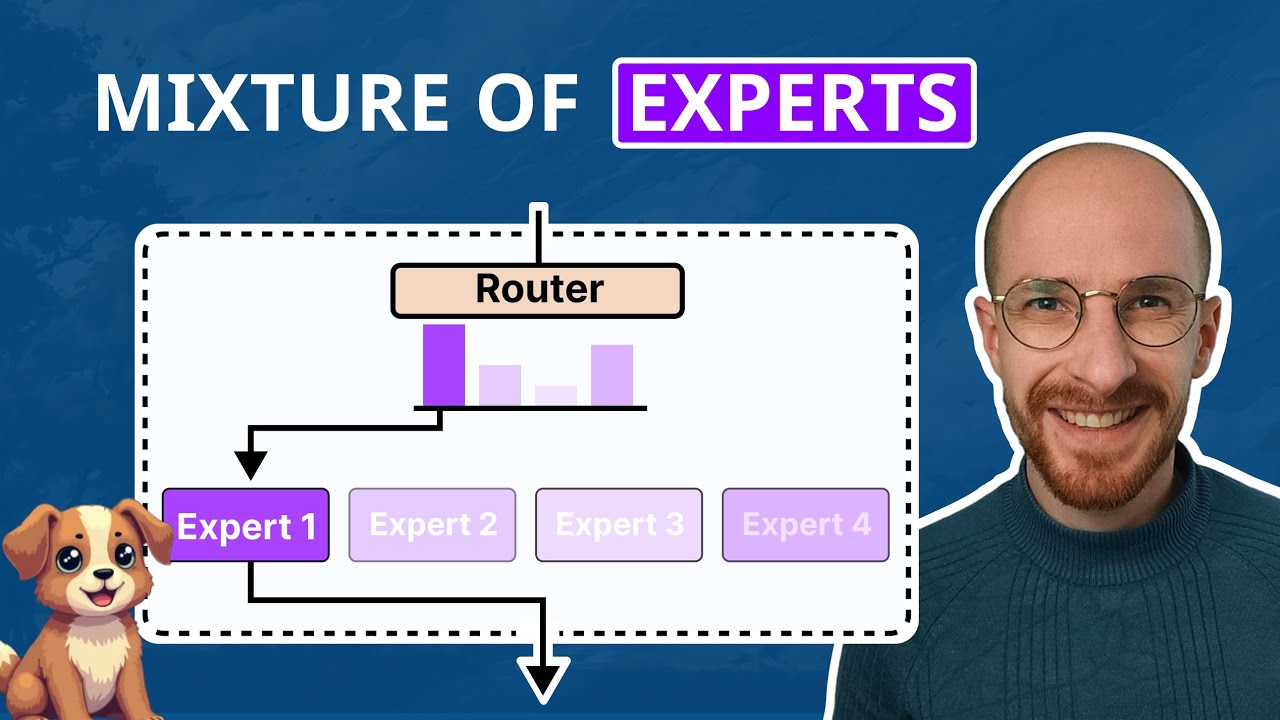
Визуальное руководство по составу экспертов в программах магистратуры по праву.

API PyTorch для высокопроизводительного обучения и вывода MoE — Д. Вега-Мюре, Ке Вэнь и Н. Гимель...

Mixture of Experts (MoE), Visually Explained

Stanford CS336: Создание языковых моделей с нуля | Весна 2025 | Лекция 4: Смесь экспертов

What is Mixture of Experts?

Fast Inference of Mixture-of-Experts Language Models with Offloading
NSDI '26 - SwiftEP: Accelerating MoE Inference with Buffer Fusion and TMA Offloading

Gemma 4 31B против Gemma 4 26B A4B (Dense против MoE): Тест в реальных условиях на 2031 задаче
How They Fixed AI's Biggest Local Hardware Problem (with FreeToken)

Stop One-Shotting MoE Models - Why They Fail and What Works

PyTorch Day India 2026 Оптимизация вывода MoE на NVIDIA Blackwell с помощью vLLM и NVFP4 Прасад Муке

Ошибки, связанные с численным равенством в обучении и выводе MoE.

Mixture of Experts (MoE) Introduction
Разбор KT-Kernel: ускорение работы MoE-моделей с помощью оптимизации CPU и SGLang
Оптимизация вывода LLM №2: тензорный, экспертный и экспертный параллелизм (TP, DP, EP, MoE)

Профилирование и оптимизация vLLM для эффективного вывода крупных мультимодальных MoE-моделей

MoE против Dense: архитектура, захватившая все передовые модели (глубокий разбор)

New Local AI Inference Engine You Should Be Using in 2027 ? (FreeToken)

1 миллион крошечных экспертов в одном ИИ? Разбор гранулярных MoE

How KV Cache Speeds Up LLMs for Faster AI Models on GPUs